Thứ Ba, 1 tháng 8, 2017

How to use css flexible box

Trong CSS, từ trước tới nay nếu chúng ta muốn dàn layout của trang thì sẽ sử dụng các thuộc tính float và kỹ thuật clear float để chia cột website như ý muốn. Hoặc muốn thuận tiện hơn thì sử dụng các CSS Grid Framework để tiết kiệm thời gian. Nhưng nói thật, nếu bạn đã từng làm việc với CSS thường xuyên thì việc chia cột đôi khi rất tốn thời gian với kỹ thuật truyền thống này, còn dùng framework thì lại khiến website chúng ta có thêm nhiều đoạn CSS không cần thiết. Hoặc là nếu chúng ta dàn trang trên kỹ thuật thông thường hiện nay thì ở mỗi thiết bị khác nhau mình phải cân đối lại kích thước khá phức tạp.
CSS3 ra đời giống như phiên bản cải thiện những nhược điểm hiện có của nó, trong đó bao gồm luôn việc cải thiện kỹ thuật dàn trang linh hoạt hơn, đơn giản hơn và thuộc tính CSS3 chúng ta sử dụng để dàn trang là Flexbox.

Flexbox là gì?

Flexbox là một kiểu dàn trang (layout mode) mà nó sẽ tự cân đối kích thước của các phần tử bên trong để hiển thị trên mọi thiết bị. Nói theo cách khác, bạn không cần thiết lập kích thước của phần tử, không cần cho nó float, chỉ cần thiết lập nó hiển thị chiều ngang hay chiều dọc, lúc đó các phần tử bên trong có thể hiển thị theo ý muốn.
Hiện nay, theo lời khuyên từ Mozilla thì chúng ta sử dụng Flexbox để thiết lập bố cục trong phạm vi nhỏ (ví dụ như những khung trong website) và khi thiết lập bố cục ở phạm vi lớn hơn (như chia cột website) thì vẫn nên sử dụng kiểu thông thường là dàn trang theo dạng lưới (grid layout).

Thuật ngữ các thành phần trong Flexbox

Trước khi đi vào tìm hiểu sâu hơn về Flexbox, chúng ta cần nắm qua cấu trúc của Flexbox là như thế nào và một số thuật ngữ liên quan.
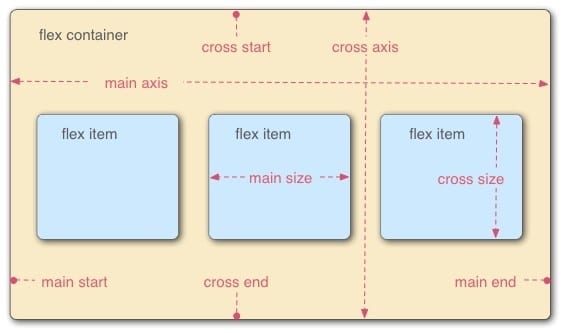
Dưới đây là sơ đồ cấu trúc Flexbox từ Mozilla Developer Network.
flex_terms
Nguồn: Mozilla Developer Network
Hai thành phần quan trọng nhất trong một bố cục Flexbox là gồm container và item:
  • container: là thành phần lớn bao quanh các phần tử bên trong, bạn sẽ thiết lập kiểu hiển thị inline (sắp xếp theo chiều ngang) hoặc kiểu sắp xếp theo chiều dọc. Khi đó, các item bên trong sẽ hiển thị dựa trên thiết lập của container này.
  • item: Các phần tử con của container được gọi là item, ở item bạn có thể thiết lập nó sẽ sử dụng bao nhiêu cột trong một container, hoặc thiết lập thứ tự hiển thị của nó.
Ngoài hai thành phần chính đó, chúng ta có thể thấy hình trên sẽ có:
  • main startmain end: Khi thiết lập flexbox, điểm bắt đầu của container gọi là main start và điểm kết thúc được gọi là main end. Điều này có nghĩa, các item bên trong sẽ heienr thị từ main start đến main end (hoặc là được phép hiển thị đến main end). Và chiều vuông góc của nó là cross startcross end cũng có ý nghĩa tương tự nhưng luôn vuông góc với main start, main end.
  • main axis: Trục này là trục chính để điều khiển hướng mà các item sẽ hiển thị. Như bạn thấy ở trên hình main axis là trục dọc nên các item sẽ hiển thị theo chiều dọc, tuy nhiên ta có thể sử dụng thuộc tính flex-directionđể thay đổi trục của main axis và lúc đó các item sẽ hiển thị theo nó. Và cross axis luôn là trục vuông góc của main axis.
  • main size: Bạn có thể hiểu đơn giản là kích thước (chiều rộng hoặc dọc) của mỗi item dựa theo trục main axis.
  • cross size: Là kích thước (chiều rộng hoặc dọc) của mỗi item dựa theo trục cross axis.

Bắt đầu với Flexbox

Trước tiên mình bắt đầu với một cấu trúc đơn giản sau:
01
02
03
04
05
06
07
08
09
10
11
12
13
14
15
16
<div class="container">
 
 
   <div class="item item1">1</div>
 
 
   <div class="item item2">2</div>
 
 
   <div class="item item3">3</div>
 
 
   <div class="item item4">4</div>
 
 
</div>
Và một đoạn CSS ban đầu để thiết lập màu sắc và kích thước để dễ nhìn từng thành phần:
01
02
03
04
05
06
07
08
09
10
11
12
13
14
15
16
/** Global CSS **/
.container {
 background: red;
 max-width: 960px;
 max-height: 1000px;
 margin: 0 auto;
 padding: 5px;
}
.item {
 background: blue;
 margin: 5px;
 color: white;
 height: 50px;
 text-align: center;
 line-height: 50px;
}
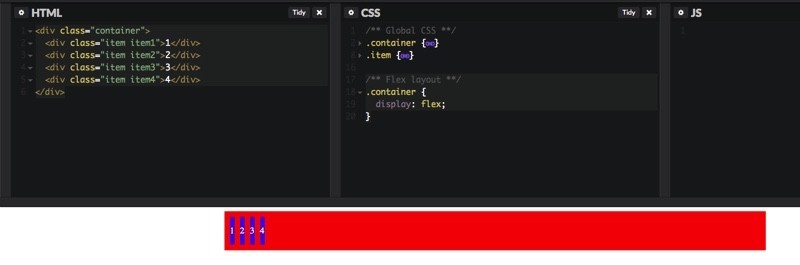
Bây giờ chúng ta sẽ bắt đầu làm việc với Flexbox ở đây. Trước tiên chúng ta sẽ đưa .container về hiển thị ở dạng flexbox với display: flex.
01
02
03
04
/** Flex layout **/
.container {
 display: flex;
}
Bạn sẽ thấy các item bên trong đã tự hiển thị theo chiều dọc, tương ứng với trục main axis mặc định là chiều ngang.
css-flexbox-01
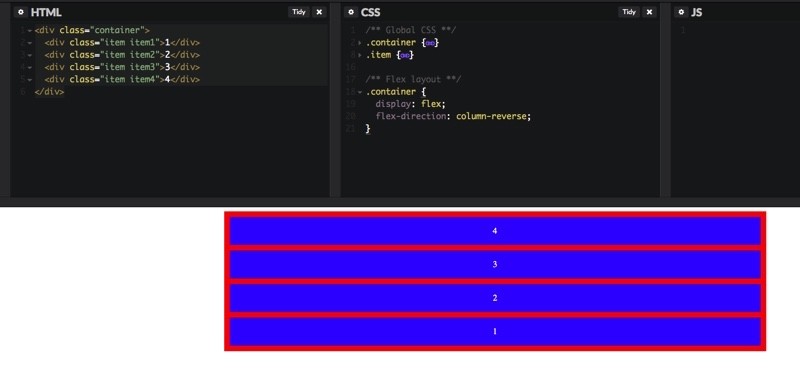
Nếu bạn muốn đổi trục thì chỉ cần thêm thuộc tính flex-direction vào container. Cụ thể:
01
flex-direction: row | column | row-reverse | column-reverse
  • flex-direction:
    • row: Chuyển trục main axis thành chiều ngang, nghĩa là hiển thị theo hàng.
    • colum: Chuyển trục main axis thành chiều dọc, nghĩa là hiển thị theo cột.
    • row-reverse: Hiển thị theo hàng nhưng đảo ngược vị trí các item.
    • column-reverse: Hiển thị theo cột nhưng đảo ngược vị trí các item.
css-flexbox-02
Quá đơn giản đúng không?

flex-wrap

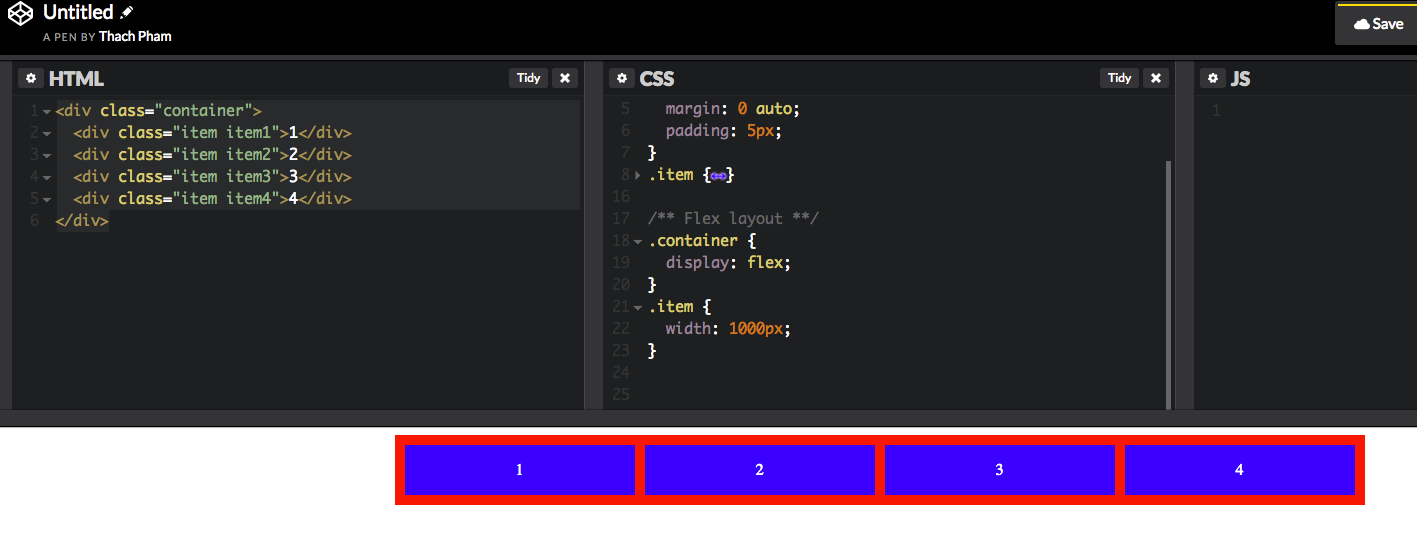
Bây giờ để hiểu cái này, chúng ta thử thêm chiều rộng cho mỗi item bên trong là 1000px xem chuyện gì sẽ xảy ra khi dùng flexbox.
01
02
03
.item {
 width: 1000px;
}
css-flexbox-03
Như bạn thấy, dù chúng ta có thêm chiều rộng cho mỗi item bên trong là 1000px nhưng nó vẫn hiển thị trên một hàng đều nhau. Lý do là mặc định, flexbox tự căn chỉnh các phần tử hiển thị đều nhau theo trục main axis của nó dựa theo chiều rộng của container. Vì vậy cho dù bạn có chỉnh chiều rộng vượt quá giới hạn của nó thì nó vẫn không bị nhảy lung tung.
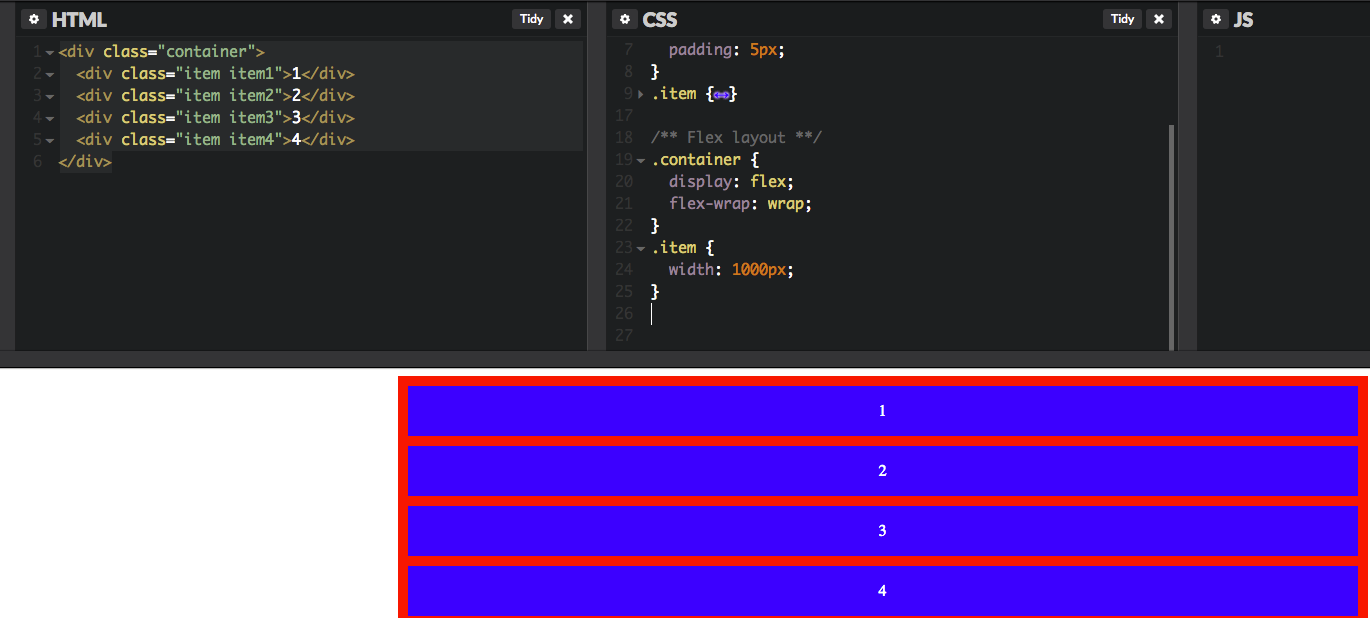
Bây giờ hãy thử thêm thuộc tính flex-wrap: wrap vào container thử nhé.
01
02
03
04
.container {
 display: flex;
 flex-wrap: wrap;
}
css-flexbox-04
Nói nôm na là thuộc tính này cho phép container có thể bọc lại các item kể cả khi kích thước của item bị thay đổi, mặc định là nowrap. Thuộc tính này có thể áp dụng với cả chiều dọc của container và item. Các bạn xem video ở trên để rõ hơn.

order

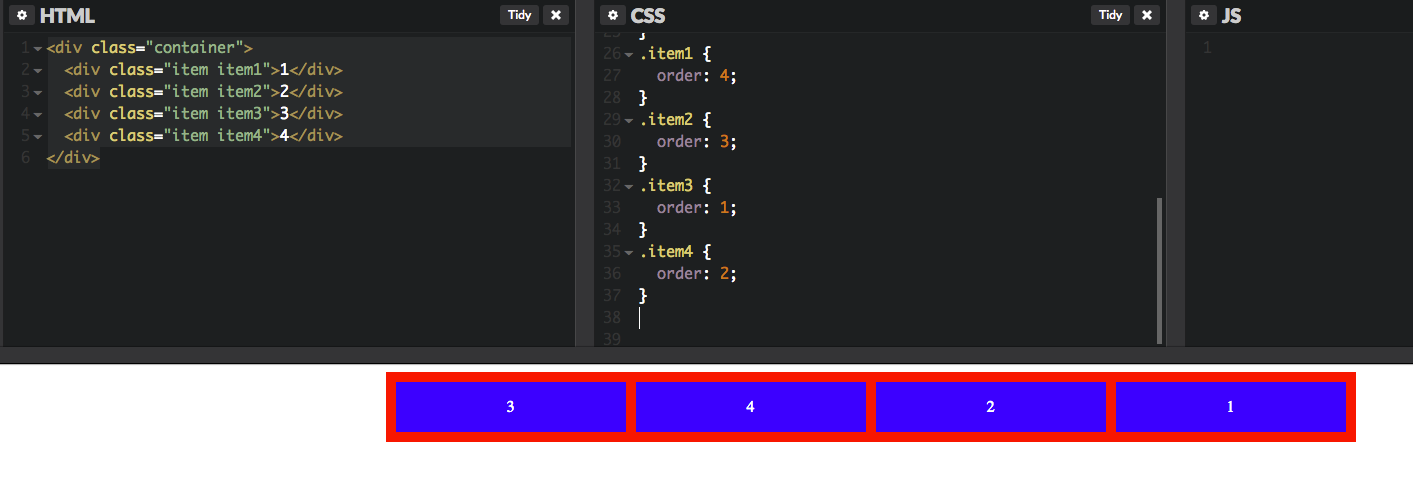
Trong đoạn HTML ví dụ của mình trong bài này, mình có đặt số thứ tự cho mỗi phần tử là 1, 2, 3 và 4 với class tương ứng là .item1, .item, .item3 và .item4. Mặc định item này sẽ hiển thị theo thứ tự trong HTML, nhưng với thuộc tính order chúng ta có thể sắp xếp lại vị trí sắp xếp của các item.
Ví dụ mình có:
01
02
03
04
05
06
07
08
09
10
11
12
.item1 {
 order: 4;
}
.item2 {
 order: 3;
}
.item3 {
 order: 1;
}
.item4 {
 order: 2;
}
css-flexbox-05
Mặc định thứ tự sắp xếp sẽ bắt đầu từ bên trái qua phải, từ trên xuống dưới. Nếu bạn chỉnh lại trục của main axis với thuộc tính flex-direction nó sẽ thay đổi ngược lại.

flex-grow

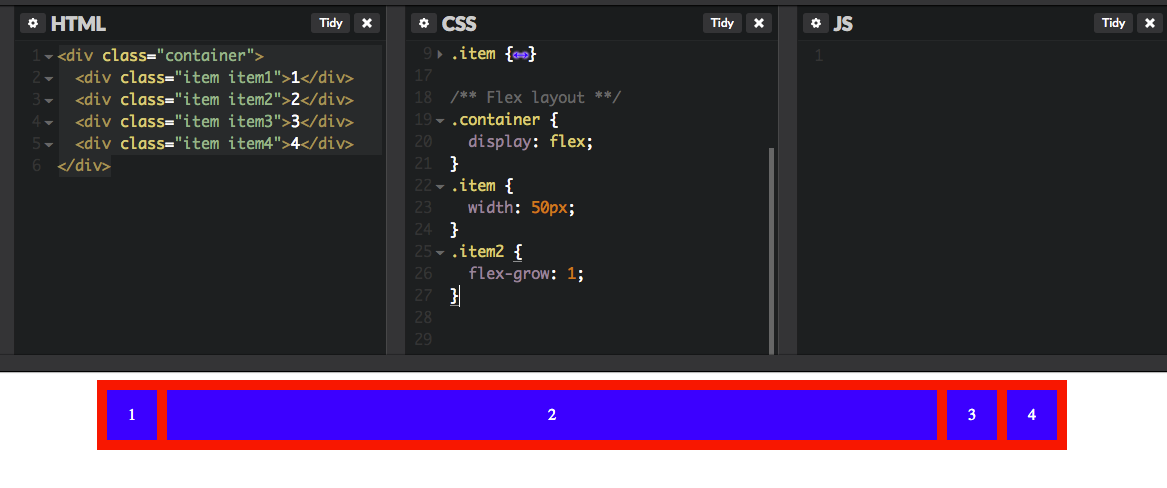
Để làm ví dụ này trước tiên mình hãy bỏ chức năng wrap đi và thiết lập chiều rộng của item là 50px.
01
02
03
.item {
 width: 50px;
}
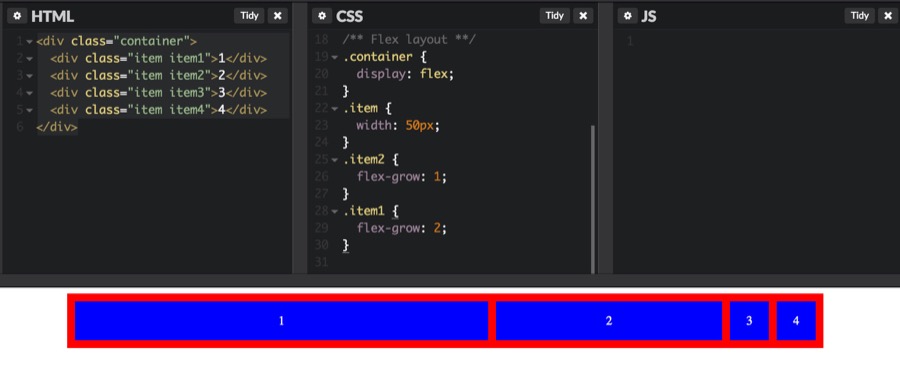
Bây giờ ở .item2, mình cho giá trị flex-grow là 1 thử nhé.
01
02
03
.item2 {
 flex-grow: 1;
}
css-flexbox-06
Khi thiết lập nó flex-grow là 1, thì nó sẽ lấy phần trống còn lại của container đắp vào. Bây giờ hãy thử cho .item1 với flex-grow: 2 thử.
01
02
03
.item1 {
 flex-grow: 2;
}
css-flexbox-07edited
Lúc này giá trị flex-grow: 2 sẽ lấy phần dư lớn gấp đôi của flex-grow: 1.

flex-shrink

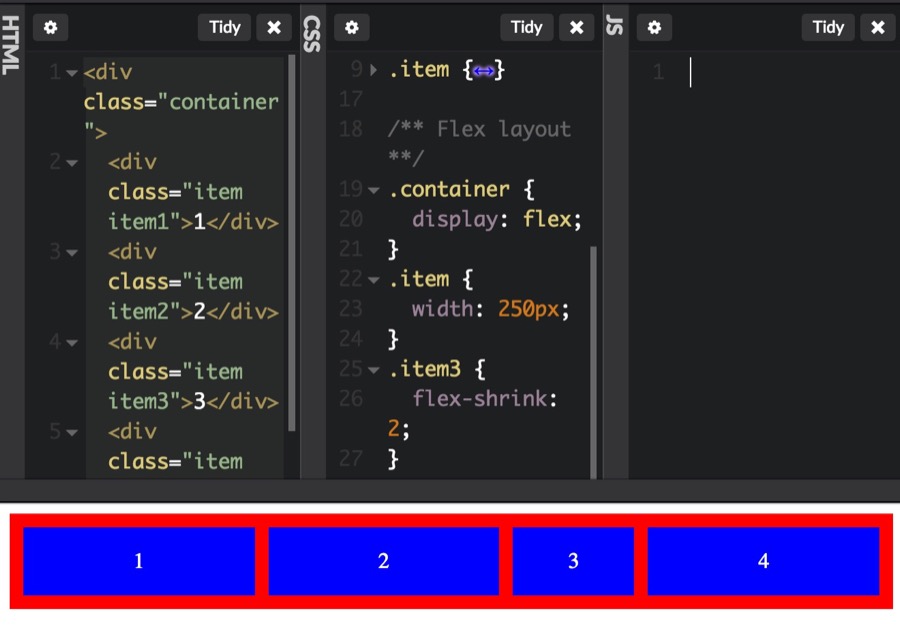
Bạn có thể hiểu mặc định tất cả các item đều có giá trị flex-shrink là 1. Điều này có nghĩa là khi chúng ta thu nhỏ trình duyệt lại, các phần tử đều co lại bằng nhau. Tuy nhiên giả sử mình muốn .item3 nó co lại nhiều hơn so với các item khác thì mình sẽ tăng giá trị flex-shrink của nó lên.
01
02
03
.item3 {
 flex-shrink: 2;
}
css-flexbox-08

flex-basis

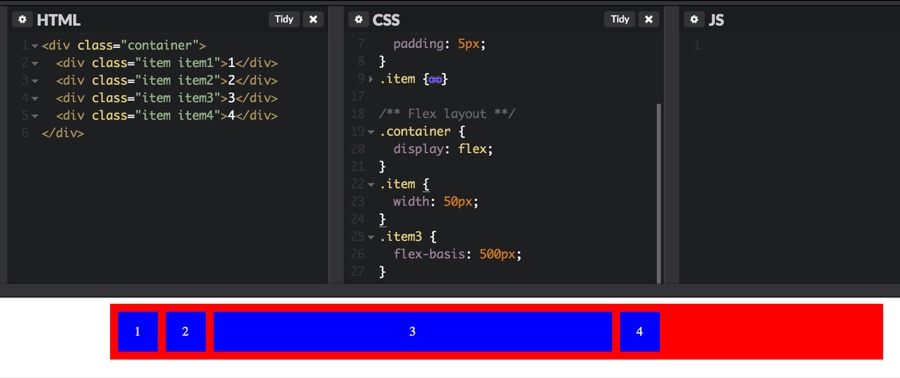
Cái này bạn có thể hiểu đơn giản nhất là gán cho item một kích thước nhất định. Bạn có thể sử dụng giá trị tuyệt đối hoặc tương đối (căn cứ theo kích thước của container).
01
02
03
.item3 {
 flex-basis: 500px;
}
css-flexbox-09

justify-content

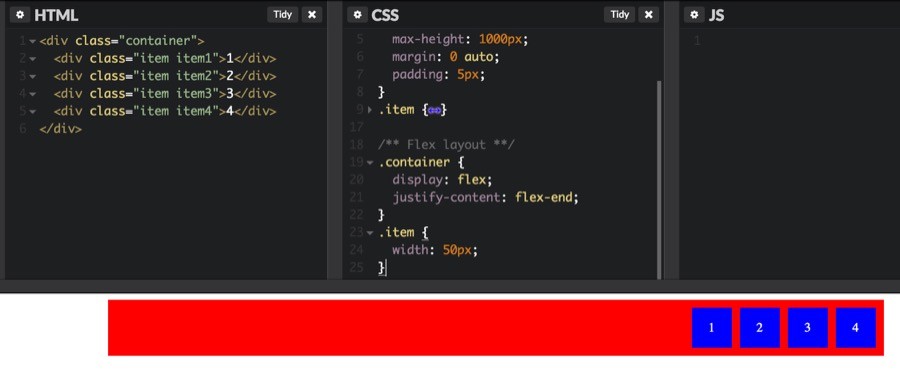
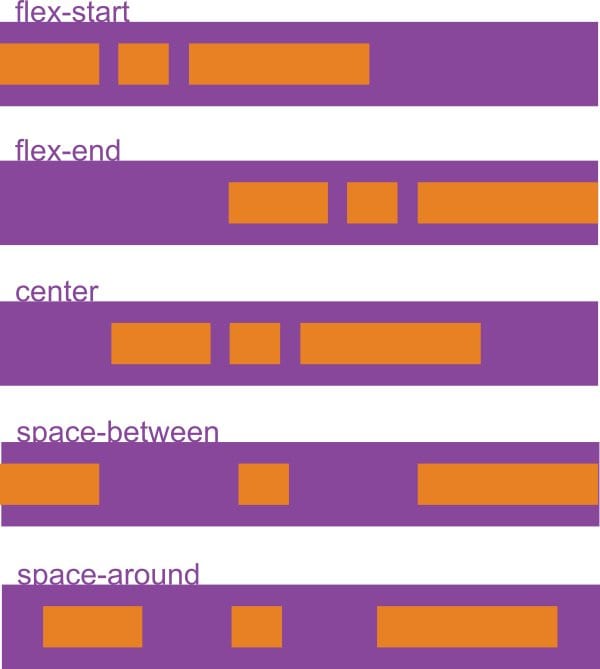
Mặc định các item bên trong sẽ rải đều bắt đầu từ main start đến main end, tuy nhiên nếu container vẫn còn khoảng trống thì có thể dùng thuộc tính justify-content để điều chỉnh lại vị trí bắt đầu của nó.
Thuộc tính này có 5 giá trị và bạn có thể xem tấm ảnh bên dưới mình mượn của CSS Tricks để hiểu hơn về ý nghĩa các giá trị của justify-content.
flexbox-justify-content
Đây là ví dụ:
01
02
03
04
.container {
 display: flex;
 justify-content: flex-end;
}
css-flexbox-10
Trong bài này mình chỉ đề cập tới một số thuộc tính hay dùng trong Flexbox thôi, bạn có thể xem thêm danh sách thuộc tính Flexbox tại đây.

Lời kết

Flexbox trong CSS có thể nói là một trong những kiểu dàn trang rất tốt để thay thế cho cách dàn trang thông thường là dùng float, thích hợp khi dàn trang những thành phần nhỏ trong website để hạn chế tối đa việc dùng float không cần thiết.
Mặc dù hiện tại chưa phải tất cả trình duyệt đều hỗ trợ CSS Flexbox nhưng trong tương lai, chắc chắn đây là một trong những tính năng mà các trình duyệt sẽ sớm hỗ trợ do khả năng tiện dụng và tùy biến tốt của nó mang lại.

Thứ Tư, 22 tháng 6, 2016

Khi đọc các bài tutorials trên mạng hoặc các video học lập trình trên mạng bạn sẽ nghe đến hai khái niệm là Request vàResponse. Thực ra hai khái niệm này khá là đơn giản, chỉ cần hiểu request là yêu cầu từ client lên server và response là server trả kết quả về cho client, tuy nhiên mục đích mình tạo ra bài viết này là để làm sáng tỏ một số vấn đề rất hữu ích cho các bạn sau này.
Trước khi đọc bài này thì phải chắn chắn rằng bạn đã đọc bài header request và header response nhé.

1. Request là gì?

Bài viết được đăng tại freetuts.net - thehalfheart@gmail.com
Request có thể hiểu nhanh là thông tin gửi từ client lên server. Khi bạn lên trình duyệt browser gõ một địa chỉ nào đó, ví dụ bạn gõ là freetuts.net thì ngay lập tức trình duyệt sẽ dựa vào tên domain để gửi yêu cầu truy cập đến địa chỉ IP mà domain này đang trỏ tới (bạn đừng quan tâm đến domain này do ai quản lý), lúc này phía server sẽ phân tích yêu cầu và sẽ gửi luồng xử lý tới vị trí vị trí lưu trữ của mã nguồn PHP (hoặc mã nguồn bất kì) và nhiệm vụ của các mã nguồn là tiếp nhận yêu cầu, phân tích request đó và trả kết quả lại cho client.
Chúng ta có hai phương thức (2 cách) để gửi request từ client lên server đó là sử dụng phương thức GET và phương thức POST. Mình đã viết một bài về chủ đề này rồi, tuy nhiên trong series này mình sẽ trình bày rõ ràng và cụ thể hơn thông qua những bài viết tiếp theo.
Khi bạn gửi request thì sẽ có rất nhiều thông tin đính kèm theo bao gồm các thông tin của trình duyệt đang sử dụng, địa chỉ IP của mạng mà máy tính bạn đang kết nối và nhiều thông tin khác. Tất cả được chia làm hai nhóm chính sau:

Nhóm 1: Nhóm Header

Nhóm 2: Nhóm chứa dữ liệu 

Nhóm này sẽ chứa dữ liệu mà client muốn truyền tải lên server của car hai phương thức POST và GET.
Ok bây giờ mình tìm hiểu làm thế nào để lấy các thông tin đó nhé.

Lấy thông tin từ client gửi lên.

Để lấy các thông tin từ client gửi lên đó chúng ta sẽ dựa vào ba biến toàn cục$_SERVER$_REQUEST$_GET và $_POST. Tuy nhiên vì đây là bài đầu tiên nên mình chỉ giới thiệu biến $_SERVER thôi nhé, 3 biến còn lại mình sẽ trình bày ở một bài khác.
Các bạn tạo một file PHP bất kì và nhập vào nội dung sau:
1
2
echo '<pre>';
var_dump($_SERVER);
Chạy file này lên bạn sẽ nhận được kết quả như hình sau:
Đây chính là một mảng gồm nhiều phần tử chứa các thông tin của client.

2. Response là gì?

Reponse là dữ liệu mà server trả về cho client. Ví dụ khi bạn nhập vào địa chỉ freetuts.net thì kết quả trả về (response) chính là giao diện của website và các thông tin của header. Như vậy dữ liệu mà server trả về là những đoạn mã HTML kèm theo các thông tin của header (xem hình).
Browser sẽ dựa vào các thông tin này để hiển thị trạng thái kết quả của request, còn mã HTML dùng để hiển thị giao diện của website. Nếu bạn nhập vào một URL không tồn tại thì thông tin của header sẽ không có gì (xem hình).

3. Lời kết

Ok bài này chỉ muốn giải thích cho các bạn hiểu request là gì và response là gì. Nếu bạn đọc bài hơi khó hiểu thì bạn hãy hiểu sơ lược như thế này:

  • Request: Là client gửi yêu cầu lên server
  • Response: Là kết quả từ server trả về cho client

Thứ Sáu, 18 tháng 12, 2015

How to install mongoDb


Step 1:

Step 2:

add extension=php_mongo.dll to php.ini

How to user compose to update library in PHP

1.step up composer
2.Link to php.exe
3.In project open file composer.json

{
    "name": "zendframework/skeleton-application",
    "description": "Skeleton Application for ZF2",
    "license": "BSD-3-Clause",
    "keywords": [
        "framework",
        "zf2"
    ],
    "homepage": "http://framework.zend.com/",
    "minimum-stability": "dev",
    "require": {
        "php": ">=5.3.3",
        "zendframework/zendframework": "2.0.2",
 "doctrine/doctrine-mongo-odm-module": "dev-master"
    }
}

4. Run php composer.phar install

Thứ Hai, 21 tháng 9, 2015

How-to-integrate-zf2-with-doctrine-mongo-odm

Step1:Tạo ứng dụng skeleton ZF2

Step 2: mở tập tin composer.json để chỉnh sửa như đoạn bên dưới (nằm ngay trong thư mục gốc của project ZF2). Đây là một file dùng để cấu hình cài đặt cho composer phar.


Thứ Năm, 23 tháng 10, 2014

Hướng dẫn kết nối git với netbean

Lấy đương dẫn từ trên trang github về,ở đây tôi lây luôn 
https://github.com/fis-gc0803-s4-g2/NTB.git


Bật netbean và clone về theo các bước sau:


Copy đường dẫn ở trên,paste vào URL,user và pass là tài khoản trên github


 Vậy là kết nối ok


Thứ Năm, 16 tháng 10, 2014

Unit Test (UT) là một kỹ thuật quan trọng góp phần nâng cao chất lượng phần mềm (PM), nhưng có nhiều quan điểm trái ngược nhau về việc đưa UT vào quy trình phát triển PM. Bài viết này giới thiệu một cái nhìn tổng quan về UT và mô hình phát triển phần mềm hiện đại TDD (Test-Driven Development).

UNIT TEST
UT là kỹ thuật kiểm nghiệm các hoạt động của mọi chi tiết mã (code) với một quy trình tách biệt với quy trình phát triển PM, giúp phát hiện sai sót kịp thời. UT còn có thể giúp phát hiện các vấn đề tiềm ẩn và các lỗi thời gian thực ngay cả trước khi chuyên viên kiểm định chất lượng (QA - Quality Assurance) tìm ra, thậm chí có thể sửa lỗi ngay từ ý tưởng thiết kế.

UT là các đoạn mã có cấu trúc giống như các đối tượng được xây dựng để kiểm tra từng bộ phận trong hệ thống. Mỗi UT sẽ gửi đi một thông điệp và kiểm tra câu trả lời nhận được đúng hay không, bao gồm:

• Các kết quả trả về mong muốn

• Các lỗi ngoại lệ mong muốn

Các đoạn mã UT hoạt động liên tục hoặc định kỳ để thăm dò và phát hiện các lỗi kỹ thuật trong suốt quá trình phát triển, do đó UT còn được gọi là kỹ thuật kiểm nghiệm tự động.

UT có các đặc điểm sau:

• Đóng vai trò như những người sử dụng đầu tiên của hệ thống.

• Chỉ có giá trị khi chúng có thể phát hiện các vấn đề tiềm ẩn hoặc lỗi kỹ thuật.

Vòng đời của UT

Một thí dụ trong NUnit. Nút xanh thể hiện các trạng thái "pass", nút đỏ ứng với trạng thái "fail" và nút vàng ứng với trạng thái "ignore".
UT có 3 trạng thái cơ bản:

• Fail (trạng thái lỗi)

• Ignore (tạm ngừng thực hiện)

• Pass (trạng thái làm việc)

Toàn bộ UT được vận hành trong một hệ thống tách biệt. Có rất nhiều PM hỗ trợ thực thi UT với giao diện trực quan. Thông thường, trạng thái của UT được biểu hiện bằng các màu khác nhau: màu xanh (pass), màu vàng (ignore) và màu đỏ (fail).

UT chỉ thực sự đem lại hiệu quả khi:

• Được vận hành lặp lại nhiều lần

• Tự động hoàn toàn

• Độc lập với các UT khác.

Thiết kế UT

Mỗi UT đều được tiết kế theo trình tự sau:

• Thiết lập các điều kiện cần thiết: khởi tạo các đối tượng, xác định tài nguyên cần thiết, xây dựng các dữ liệu giả...

• Triệu gọi các phương thức cần kiểm tra.

• Kiểm tra sự hoạt động đúng đắn của các phương thức.

• Dọn dẹp tài nguyên sau khi kết thúc kiểm tra.

Ứng dụng của UT
• Kiểm tra mọi đơn vị nhỏ nhất là các thuộc tính, sự kiện, thủ tục và hàm.

• Kiểm tra các trạng thái và ràng buộc của đối tượng ở các mức sâu hơn mà thông thường chúng ta không thể truy cập được.

• Kiểm tra các quy trình (process) và mở rộng hơn là các khung làm việc(workflow - tập hợp của nhiều quy trình).

Lợi ích của UT

Thời gian đầu, người ta thường do dự khi phải viết UT thay vì tập trung vào viết mã cho các chức năng nghiệp vụ. Công việc viết UT có thể ngốn nhiều thời gian, yuy nhiên UT đem lại lợi ích to lớn như:

• Tạo ra môi trường lý tưởng để kiểm tra bất kỳ đoạn mã nào, có khả năng thăm dò và phát hiện lỗi chính xác, duy trì sự ổn định của toàn bộ PM và giúp tiết kiệm thời gian so với công việc gỡ rối truyền thống.

• Phát hiện các thuật toán thực thi không hiệu quả, các thủ tục chạy vượt quá giới hạn thời gian.
• Phát hiện các vấn đề về thiết kế, xử lý hệ thống, thậm chí các mô hình thiết kế.

• Phát hiện các lỗi nghiêm trọng có thể xảy ra trong những tình huống rất hẹp.

• Tạo hàng rào an toàn cho các khối mã: Bất kỳ sự thay đổi nào cũng có thể tác động đến hàng rào này và thông báo những nguy hiểm tiềm tàng.
UT tạo thành hàng rào an toàn cho mã ứng dụng
 
• UT là môi trường lý tưởng để tiếp cận các thư viện API bên ngoài một cách tốt nhất. Sẽ rất nguy hiểm nếu chúng ta ứng dụng ngay các thư viện này mà không kiểm tra kỹ lưỡng công dụng của các thủ tục trong thư viện. Dành ra thời gian viết UT kiểm tra từng thủ tục là phương pháp tốt nhất để khẳng định sự hiểu đúng đắn về cách sử dụng thư viện đó. Ngoài ra, UT cũng được sử dụng để phát hiện sự khác biệt giữa phiên bản mới và phiên bản cũ của cùng một thư viện.

Trong môi trường làm việc cạnh tranh, UT còn có tác dụng rất lớn đến năng suất làm việc:

• Giải phóng chuyên viên QA khỏi các công việc kiểm tra phức tạp.

• Tăng sự tự tin khi hoàn thành một công việc. Chúng ta thường có cảm giác không chắc chắn về các đoạn mã của mình như liệu các lỗi có quay lại không, hoạt động của module hiện hành có bị tác động không, hoặc liệu công việc hiệu chỉnh mã có gây hư hỏng đâu đó...

• Là công cụ đánh giá năng lực của bạn. Số lượng các tình huống kiểm tra (test case) chuyển trạng thái "pass" sẽ thể hiện tốc độ làm việc, năng suất của bạn.

Chiến lược viết mã hiệu quả với UT

• Phân tích các tình huống có thể xảy ra đối với mã. Đừng bỏ qua các tình huống tồi tệ nhất có thể xảy ra, thí dụ dữ liệu nhập làm một kết nối cơ sở dữ liệu thất bại, ứng dụng bị treo vì một phép toán chia cho không, các thủ tục đưa ra lỗi ngoại lệ sai có thể phá hỏng ứng dụng một cách bí ẩn...

• Mọi UT phải bắt đầu với trạng thái "fail" và chuyển trạng thái "pass" sau một số thay đổi hợp lý đối với mã chính.

• Mỗi khi viết một đoạn mã quan trọng, hãy viết các UT tương ứng cho đến khi bạn không thể nghĩ thêm tình huống nào nữa.

• Nhập một số lượng đủ lớn các giá trị đầu vào để phát hiện điểm yếu của mã theo nguyên tắc:
- Nếu nhập giá trị đầu vào hợp lệ thì kết quả trả về cũng phải hợp lệ

- Nếu nhập giá trị đầu vào không hợp lệ thì kết quả trả về phải không hợp lệ

• Sớm nhận biết các đoạn mã không ổn định và có nguy cơ gây lỗi cao, viết UT tương ứng để khống chế.

• Ứng với mỗi đối tượng nghiệp vụ (business object) hoặc đối tượng truy cập dữ liệu (data access object), nên tạo ra một lớp kiểm tra riêng vì những lỗi nghiêm trọng có thể phát sinh từ các đối tượng này.
• Để ngăn chặn các lỗi có thể phát sinh trở lại thực thi tự động tất cả UT mỗi khi có một sự thay đổi quan trọng, hãy làm công việc này mỗi ngày. Các UT lỗi cho chúng ta biết thay đổi nào là nguyên nhân gây lỗi.

• Để tăng hiệu quả và giảm rủi ro khi viết các UT, cần sử dụng nhiều phương thức kiểm tra khác nhau. Hãy viết càng đơn giản càng tốt.

• Cuối cùng, viết UT cũng đòi hỏi sự nỗ lực, kinh nghiệm và sự sáng tạo như viết PM.

Trước khi kết thúc phần này, chúng tôi có một lời khuyên là viết UT cũng tương tự như viết mã một chương trình, điều bạn cần làm là không ngừng thực hành. Hãy nhớ UT chỉ thực sự mang lại lợi ích nếu chúng ta đặt vấn đề chất lượng phần mềm lên hàng đầu hơn là chỉ nhằm kết thúc công việc đúng thời hạn. Khi đã thành thạo với công việc viết UT, bạn có thể đọc thêm về các kỹ thuật xây dựng UT phức tạp hơn, trong số đó có mô hình đối tượng ảo sẽ được trình bày trong phần tiếp theo.
UT tương tác với cả đối tượng ảo và đối tượng thực
XÂY DỰNG UT VỚI MÔ HÌNH ĐỐI TƯỢNG ẢO (MOCK OBJECT)

Trong UT, mỗi một đối tượng hay một phương thức riêng lẻ được kiểm tra tại một thời điểm và chúng ta chỉ quan tâm đến các trách nhiệm của chúng có được thực hiện đúng hay không. Tuy nhiên trong các dự án PM phức tạp thì UT không còn là quy trình riêng lẻ, nhiều đối tượng (đơn vị chương trình) không làm việc độc lập mà tương tác với các đối tượng khác như kết nối mạng, cơ sở dữ liệu hay dịch vụ web. Như vậy công việc kiểm nghiệm có thể bị trì hoãn gây tác động xấu đến quy trình phát triển chung. Để giải quyết các vấn đề này người ta đưa ra mô hình "Mock Object" hay đối tượng ảo (hoặc đối tượng giả).

Định nghĩa
Mock object (MO) là một đối tượng ảo mô phỏng các tính chất và hành vi giống hệt như đối tượng thực được truyền vào bên trong khối mã đang vận hành nhằm kiểm tra tính đúng đắn của các hoạt động bên trong.

Đặc điểm 

• Đơn giản hơn đối tượng thực nhưng vẫn giữ được sự tương tác với các đối tượng khác.

• Không lặp lại nội dung đối tượng thực.

• Cho phép thiết lập các trạng thái riêng trợ giúp kiểm tra.

Lợi ích 

• Đảm bảo công việc kiểm nghiệm không bị gián đoạn bởi các yếu tố bên ngoài, giúp các chuyên viên tập trung vào một chức năng nghiệp vụ cụ thể, từ đó tạo ra UT vận hành nhanh hơn.

• Giúp tiếp cận hướng đối tượng tốt hơn. Nhờ MO chúng ta có thể phát hiện interface cần tách ở một số lớp.

• Dễ dàng cho việc kiểm nghiệm. Thay vì gọi các đối tượng thực vận hành nặng nề, chúng ta có thể gọi các MO đơn giản hơn để kiểm tra nhanh liên kết giữa các thủ tục, công việc kiểm nghiệm có thể tiến hành nhanh hơn.

Phạm vi sử dụng
MO được sử dụng trong các trường hợp sau:

• Cần lập trạng thái giả của một đối tượng thực trước khi các UT có liên quan được đưa vào vận hành (thí dụ kết nối cơ sở dữ liệu, giả định trạng thái lỗi server...)

• Cần lập trạng thái cần thiết cho một số tính chất nào đó của đối tượng đã bị khoá quyền truy cập (các biến, thủ tục, hàm, thuộc tính riêng được khai báo private). Không phải lúc nào các tính chất của một đối tượng cũng có thể được mở rộng phạm vi truy cập ra bên ngoài vì điều này có thể trực tiếp phá vỡ liên kết giữa các phương thức theo một trình tự sắp đặt trước, từ đó dẫn đến kết quả có thể bị xử lý sai. Tuy nhiên, MO có thể thiết lập các trạng thái giả mà vẫn đảm bảo các yêu cầu ràng buộc, các nguyên tắc đúng đắn và các quan hệ của đối tượng thực.

• Cần kiểm tra một số thủ tục hoặc các biến của thành viên bị hạn chế truy cập. Bằng cách kế thừa MO từ đối tượng thực chúng ta có thể kiểm tra các thành viên đã được bảo vệ (khai báo protected).

• Cần loại bỏ các hiệu ứng phụ của một đối tượng nào đó không liên quan đến UT.

• Cần kiểm nghiệm mã vận hành có tương tác với hệ thống bên ngoài.

Các dạng đối tượng được mô phỏng

MO mô phỏng các loại đối tượng sau đây:

• Các đối tượng thực mới chỉ được mô tả trên bản thiết kế nhưng chưa tồn tại dưới dạng mã, hoặc các module chưa sẵn sàng cung cấp các dữ liệu cần thiết để vận hành UT.

• Các đối tượng thực có các thủ tục chưa xác định rõ ràng về mặt nội dung (mới chỉ mô tả trong interface) nhưng được đòi hỏi sử dụng gấp trong các UT.

• Các đối tượng thực rất khó cài đặt (thí dụ đối tượng xử lý các trạng thái của server)

• Các đối tượng thực xử lý một tình huống khó xảy ra. Thí dụ lỗi kết nối mạng, lỗi ổ cứng...

• Các đối tượng có các tính chất và hành vi phức tạp, các trạng thái luôn thay đổi và các quan hệ chặt chẽ với nhiều đối tượng khác

• Các đối tượng vận hành chậm chạp. Công việc kiểm tra hiện hành không liên quan đến thao tác xử lý đối tượng này.

• Đối tượng thực liên quan đến giao diện tương tác người dùng. Không người dùng nào có thể ngồi kiểm nghiệm các chức năng hộ bạn hết ngày này qua ngày khác. Tuy nhiên bạn có thể dùng MO để mô phỏng thao tác của người dùng, nhờ đó công việc có thể được diễn biến lặp lại và hoàn toàn tự động.

Thiết kế MO

Thông thường, nếu số lượng MO không nhiều, chúng ta có thể tự thiết kế. Nếu không muốn mất nhiều thời gian tự thiết kế một số lượng lớn MO, bạn có thể tải về các công cụ có sẵn thông dụng hiện nay như EasyMock, jMock, Nmock... Các phần mềm này cung cấp nhiều API cho phép xây dựng MO và các kho dữ liệu giả dễ dàng hơn, cũng như kiểm tra tự động các số liệu trong UT. Nói chung, việc thiết kế MO gồm 3 bước chính sau đây:
1. Đưa ra interface để mô tả đối tượng. Tất cả các tính chất và thủ tục quan trọng cần kiểm tra phải được mô tả trong interface.

2. Viết nội dung cho đối tượng thực dựa trên interface như thông thường.

3. Trích interface từ đối tượng thực và triển khai MO dựa trên interface đó.

Lưu ý MO phải được đưa vào quy trình kiểm nghiệm tách biệt. Cách này có thể sinh ra nhiều interface không thực sự cần thiết, có thể làm cho thiết kế ứng dụng trở nên phức tạp. Một cách làm khác là kế thừa một đối tượng đang tồn tại và cố gắng mô phỏng các hành vi càng đơn giản càng tốt, như trả về một dữ liệu giả chẳng hạn. Đặc biệt tránh tạo ra những liên kết mắt xích giữa các MO vì chúng có thể làm cho thiết kế UT trở nên phức tạp.

TEST-DRIVEN DEVELOPMENT
Trong những năm gần đây, khái niệm TDD được đưa ra dựa trên mô hình phát triển PM khá nổi tiếng XP (Extreme Programming). TDD là một chiến lược phát triển sử dụng kỹ thuật UT theo nguyên tắc tạo ra các công đoạn kiểm nghiệm trước khi xây dựng mã.

Ý tưởng chính của TDD: Trước khi bạn bắt tay viết mã, hãy nghĩ về những gì phải làm trước. Không giống như lập trình truyền thống, trong TDD chúng ta viết mã kiểm tra trước khi viết mã chính, chỉ được viết sau khi đạt đủ số lượng UT cần thiết cho các tình huống có thể xảy ra.

Có thể hiểu TDD là một quy trình vòng tròn bắt đầu bởi các UT với trạng thái đầu tiên là "fail", tiếp theo cần viết mã để các UT chuyển trạng thái "pass", và cuối cùng hiệu chỉnh mã cho đơn giản hơn. Quy trình này được tái diễn liên tục đối với mọi đơn vị chương trình cho đến khi kết thúc hoàn toàn dự án.

Đặc điểm
• Là quy trình phát triển tăng dần theo kịch bản và gắn chặt với các công đoạn kiểm nghiệm trước khi đưa ứng dụng vào vận hành thực sự.

• Là phương pháp phát triển PM ở đó áp dụng kỹ thuật UT tiến hành kiểm tra tất cả các interface, tạo ra các MO cần thiết mô phỏng sự vận hành của ứng dụng ở một nơi riêng biệt.

• Tạo ra bộ khung vận hành tự động cho tất cả các thao tác kiểm nghiệm bộ phận trong hệ thống mỗi khi xây dựng một phiên bản mới.

Lợi ích

• TDD là một kỹ thuật giúp định hình ý tưởng thiết kế hơn là kiểm nghiệm mã chương trình. Thực hiện theo TDD sẽ làm sáng tỏ thêm các yêu cầu bài toán, giải tỏa sự bế tắc trong khi đi tìm giải pháp, phát hiện sớm các vấn đề về thiết kế và tránh được những công việc phải làm lại.

• TDD là một phần bổ trợ không thể thiếu trong các công việc lập trình theo nhóm nhỏ, thường là hai người cùng phát triển một module. Trong mô hình này, luân phiên một người có nhiệm vụ nghĩ về tình huống kiểm tra tiếp theo, viết UT cho tình huống và các MO cần thiết. Người còn lại tập trung viết mã để các UT chuyển sang trạng thái "pass"; giúp giảm thiểu lỗi so với khi làm việc độc lập.

• TDD định hướng cho nhóm thiết kế vận dụng tốt các phương pháp hướng đối tượng (các đối tượng cần kiểm tra phải thực thi một interface là một thí dụ), đặc biệt có thể thu được thiết kế tốt theo hai nguyên tắc:

- Loosely-Coupled: Bất kỳ sự thay đổi nào cũng đều không ảnh hưởng đến các đối tượng khác.

- Highly-Cohesive: Có tính chất khép kín theo nghĩa chỉ thực hiện những chức năng gần với nhau về mặt nghiệp vụ và thiết kế, đồng thời loại ra những chức năng ít có liên quan đến các chức năng chính.

• Lợi ích quan trọng cuối cùng của TDD là xây dựng các đoạn mã chất lượng và an toàn, tập trung hơn, giảm phân mảnh mã và giảm rủi ro xảy ra ngoài dự kiến.

Trong TDD, càng nhiều UT được tạo ra thì càng có nhiều khả năng khống chế nhanh chóng các lỗi nghiêm trọng xảy ra. Các UT càng "mịn" theo nghĩa không thể chia nhỏ hoặc không thể bổ sung được nữa thì khả năng đáp ứng yêu cầu kiểm nghiệm càng cao. Khi đã thiết kế đủ các UT có khả năng phát hiện chính xác bất kỳ một lỗi kỹ thuật nào, chúng ta có thể yên tâm chuyển giao module cho chuyên viên QA kiểm định chức năng (functional testing). Tuy nhiên trong suốt giai đoạn phát triển sau đó cần kiểm tra định kỳ các trạng thái của UT để đảm bảo việc cập nhật không phá vỡ tính đúng đắn của các đoạn mã cũ.

Quy trình thực hiện
Trình tự thực hiện trong TDD như sau:

1. Đối với một module, nghĩ về các công việc sẽ làm và cách kiểm tra công việc đó như thế nào.

2. Tạo test suite ứng với module đó.

3. Bắt tay thiết kế sơ bộ tất cả các UT có thể nghĩ ra. Bước này thực chất là thu thập các tình huống có thể phát hiện lỗi vào một danh sách công việc cần kiểm nghiệm.

4. Viết mã để đảm bảo các UT được biên dịch.

5. Thực thi các UT, vì mã chính của module chưa tồn tại nên trạng thái là "fail".

6. Viết mã cho module để thay đổi trạng thái UT, có thể bổ sung UT nếu cần thiết.

7. Chạy lại toàn bộ test suite và quan sát các UT lỗi, lặp lại bước 6-7 cho đến khi tất cả UT đều đạt trạng thái "pass".

8. Hiệu chỉnh mã để loại bỏ các phần lặp lại, các khối mã và các phân nhánh, liên kết thiếu hợp lý hoặc các khối mã không còn hoạt động... đồng thời viết chú giải các phần quan trọng. Hãy thực hiện công việc này thường xuyên vì chúng ta sẽ không có thời gian quay lại cho công việc hiệu chỉnh.

Bước cuối cùng có ý nghĩa rất lớn trong việc giảm sự phụ thuộc vào các module khác và gia tăng sự độc lập về mặt nghiệp vụ của module hiện hành. Cần lưu ý kiểm tra lại trạng thái tất cả các UT sau mỗi lần hiệu chỉnh vì rất có thể công việc này sẽ gây ra lỗi ở đâu đó.

Chiến lược phát triển với TDD

Mỗi công ty PM đều có cách điều hành quản lý phát triển PM khác nhau, nhưng tất cả đều có chung một mục đích là giảm số lỗi xuống mức nhỏ nhất có thể và khống chế lỗi phát sinh trở lại. Tuy nhiên nhìn chung một quy trình phát triển PM lý tưởng không thể thiếu các bước quan trọng sau đây:

• Thiết kế một dự án thử nghiệm riêng, độc lập, tách biệt với khu vực phát triển. Không gắn dự án thử nghiệm đó vào phiên bản sản phẩm được giao cho khách hàng, vì điều này có thể làm tăng kích thước sản phẩm.

• Xây dựng một cơ sở dữ liệu các test suite cho mọi module phục vụ việc kiểm nghiệm cả hai khía cạnh phát triển và chức năng.

• Chia nhỏ dự án ra nhiều quy trình nhỏ hơn dựa trên ngữ cảnh, giúp việc viết UT được dễ dàng hơn. Để kiểm tra hiệu quả của toàn bộ ứng dụng, tốt nhất là kiểm tra hiệu quả của mọi đơn vị mã nhỏ nhất.

• Có thể thiết lập các cơ sở dữ liệu riêng cho dự án thử nghiệm lưu trữ tất cả các giá trị đầu vào và các kết quả trả về mong muốn... XML sẽ là cách tiếp cận tốt nhất cho những cơ sở dữ liệu loại này.

• Tích hợp công việc kiểm nghiệm thành một phần trong quy trình tự động hoá quản lý mã nguồn như tích hợp toàn bộ công việc, biên dịch vào cuối ngày làm việc... Mỗi một công việc như vậy được gọi là một "build". Về quy trình này có thể tham khảo ứng dụng nguồn mở Ant trong Java (hoặc NAnt cho .NET), hay các công cụ thương mại như CruiseControl hoặc Anthill.

• Cuối cùng thay vì kiểm nghiệm bằng tay, hãy để máy tính thực hiện tự động và gửi báo cáo cho bạn. Các thông báo email tự động hàng ngày về tình trạng của các UT sẽ luôn đảm bảo cho dự án thông suốt. Tất cả các công việc này có thể được tiến hành trên một máy tính riêng có khả năng kiểm soát các thay đổi mã nguồn.

LỜI KẾT

UT là một phương pháp hỗ trợ phát triển PM đang được áp dụng và vẫn đang được hoàn thiện. Kết hợp UT với chiến lược phát triển TDD sẽ giúp bạn xây dựng được các PM chất lượng và ổn định.